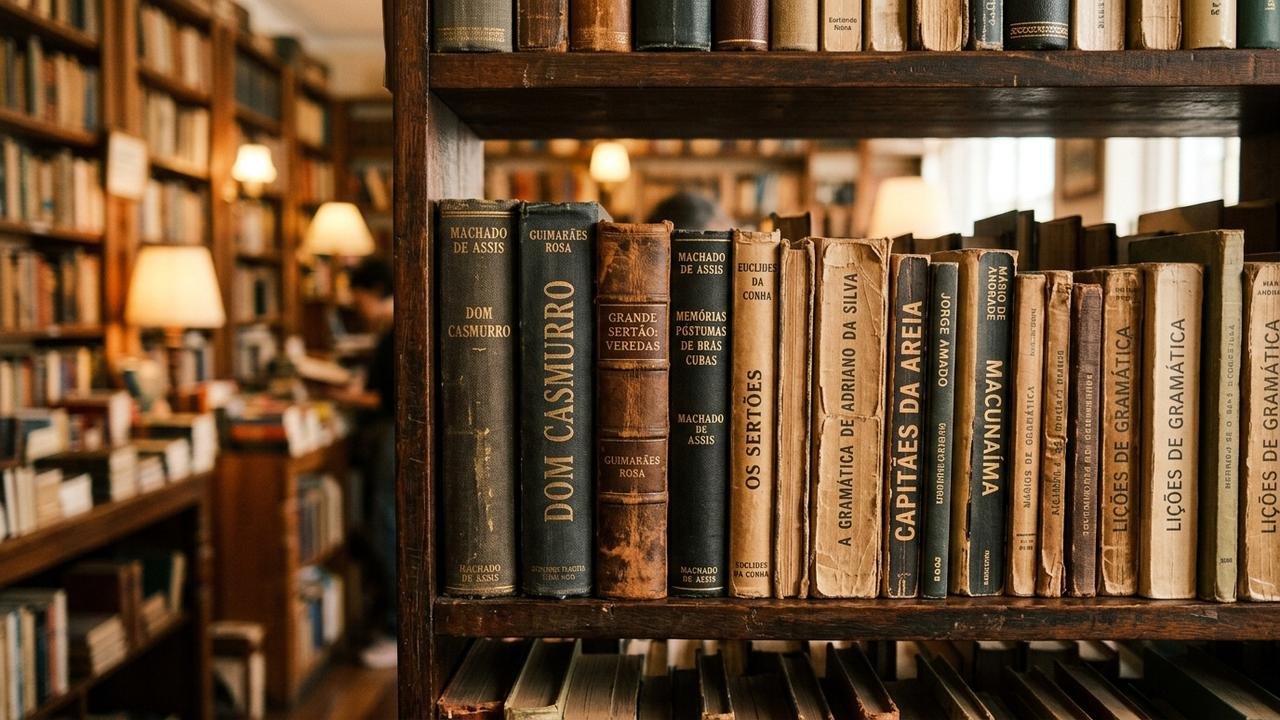
Livros impressos publicados antes da explosão da inteligência artificial generativa estão ganhando um valor inesperado: tornaram-se uma fonte cobiçada de texto produzido por humanos para treinar novos modelos. Documentos judiciais e investigações recentes mostram que empresas como Anthropic e Amazon chegaram a comprar obras físicas em grande escala, digitalizá-las e, em alguns casos, destruir os exemplares durante o processo.
Por que livros anteriores a 2022 ficaram tão valiosos
O principal atrativo está na origem do conteúdo. Obras publicadas antes de 2022 pertencem, em sua enorme maioria, a um período anterior à popularização dos grandes geradores de texto, o que reduz o risco de incluir conteúdo criado por IA nos conjuntos usados para treinamento.
Isso não significa que qualquer livro antigo seja automaticamente melhor para uma inteligência artificial. O interesse está principalmente na combinação de texto humano verificável, revisão editorial, diversidade de assuntos e conteúdos que muitas vezes nunca foram publicados integralmente na internet.
A Anthropic comprou milhões de livros e cortou suas lombadas
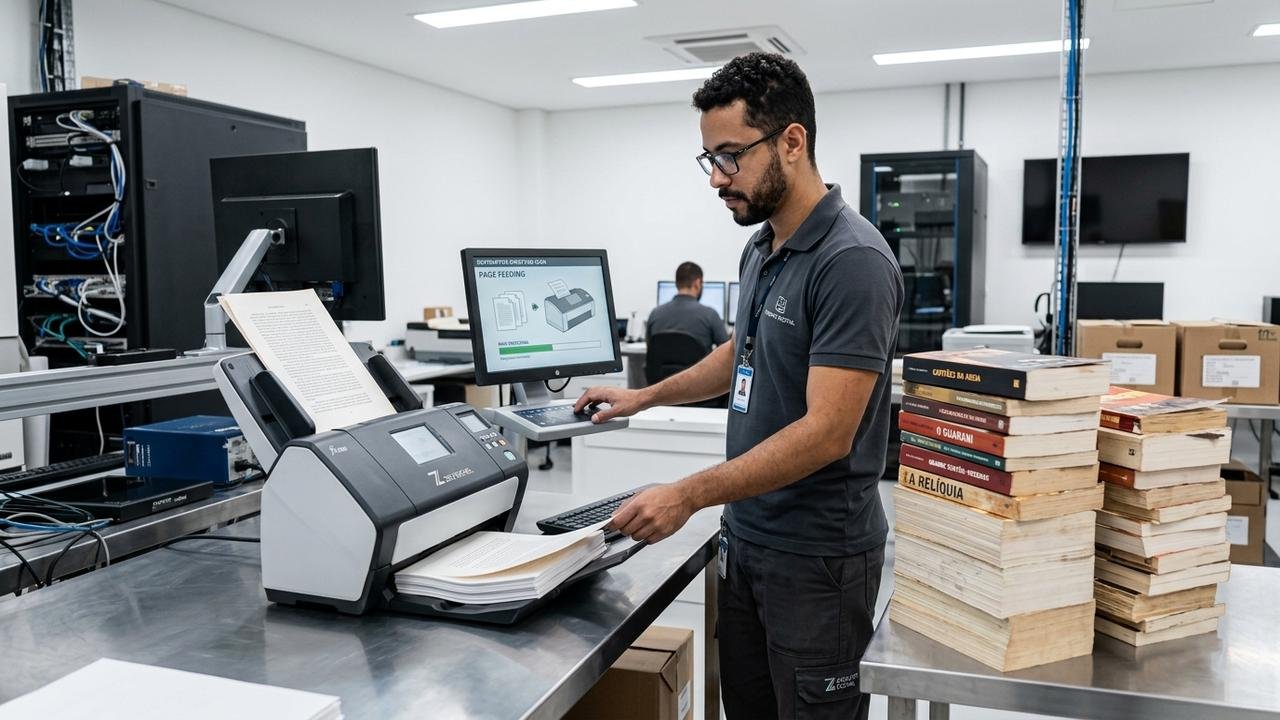
O caso mais documentado envolve a Anthropic, desenvolvedora do Claude. Documentos revelados no processo Bartz v. Anthropic mostraram que a empresa gastou milhões de dólares comprando milhões de livros impressos, muitos deles usados, antes de encaminhá-los para digitalização em escala industrial.
O método era chamado de digitalização destrutiva. Prestadores de serviço retiravam a encadernação, cortavam as páginas no tamanho adequado para scanners de alta velocidade e criavam arquivos digitais pesquisáveis. Os exemplares físicos eram descartados depois da conversão, conforme registrou uma decisão da Justiça federal dos Estados Unidos.
Documentos internos posteriormente analisados pelo Washington Post identificaram a iniciativa como Projeto Panamá. Um fornecedor chegou a preparar uma operação capaz de converter entre 500 mil e 2 milhões de livros em apenas seis meses.
Leia Também
A Amazon também foi ligada à digitalização de obras físicas
Em agosto de 2026, uma investigação rastreou uma remessa de aproximadamente mil livros até uma instalação da Amazon em Las Vegas. Segundo informações reunidas pela Inc., trabalhadores do local cortavam encadernações e digitalizavam páginas; a Amazon confirmou que compra livros por canais comerciais para desenvolver e melhorar produtos e serviços, mas não informou quantos exemplares foram adquiridos nem detalhou quais sistemas recebem esses dados.
Leia também: Morador troca vários eletrodomésticos após quedas frequentes de energia, mas defeito estava dentro da própria casa
O problema é que a própria IA está contaminando a internet
Durante anos, empresas puderam coletar enormes volumes de páginas da web para treinar modelos de linguagem. A expansão dos geradores de texto mudou esse cenário porque ficou cada vez mais difícil distinguir, em grandes bases coletadas automaticamente, o que foi escrito por uma pessoa e o que foi produzido por outro modelo de IA.
Uma pesquisa publicada na revista Nature mostrou que o uso indiscriminado e recorrente de dados produzidos por modelos anteriores pode provocar o chamado colapso do modelo. Nesse processo, informações menos frequentes podem desaparecer progressivamente e a distribuição aprendida pelo sistema fica cada vez mais distante dos dados humanos originais.
O estudo não significa que todo dado sintético seja prejudicial. Dados artificiais cuidadosamente produzidos e misturados a fontes reais podem ter aplicações úteis. O problema aparece quando sistemas passam a aprender repetidamente com suas próprias reproduções sem preservar quantidade suficiente de dados originais.
Comprar o livro não encerra a discussão sobre direitos autorais
Em junho de 2025, o juiz William Alsup decidiu que a conversão individual de livros físicos legalmente comprados pela Anthropic em arquivos digitais poderia ser considerada fair use nas circunstâncias analisadas. A decisão destacou que o exemplar físico era destruído enquanto uma única versão digital o substituía na biblioteca interna da empresa.
O mesmo processo, porém, separou essa situação da obtenção de obras em bibliotecas digitais piratas. A Anthropic também havia baixado mais de 7 milhões de cópias de livros de fontes como LibGen e PiLiMi, conduta que não recebeu a mesma proteção jurídica. A disputa terminou em um acordo de US$ 1,5 bilhão relacionado às obras obtidas dessas fontes piratas.
O que pode acontecer com os livros usados e raros
Para leitores, livreiros e bibliotecas, a questão mais delicada não está nos milhões de exemplares comuns que circulam no mercado, mas em obras fora de catálogo, edições difíceis de substituir e cópias com características históricas próprias. A digitalização destrutiva transforma o texto em dados, mas elimina definitivamente aquele objeto físico.
Por isso, grandes compras aparentemente aleatórias de livros antigos passaram a receber mais atenção. O avanço da IA criou um paradoxo: quanto mais conteúdo artificial aparece na internet, maior pode se tornar o valor de acervos produzidos antes dessa expansão. Nesse cenário, preservar fontes comprovadamente humanas pode ser tão relevante para o desenvolvimento dos próximos modelos quanto conseguir mais capacidade computacional.